Python na base da marreta
Enquanto estive na tutoria da Digital House, dados dos estudantes estavam dispersos entre sistemas que não se comunicavam. Scripts em Python extraíram, converteram e reuniram essas informações em planilhas de acompanhamento compartilhadas.
Não sou exatamente um programador ou desenvolvedor. Entendia meu jeito de resolver problemas com Python como “estilo marreta”.
Em outras palavras: quando não se tem um profissional ou a ferramenta certa à mão, usa-se uma marreta, ou um alicate universal, para resolver coisas. Nem sempre era elegante. Mas funcionava para aquele problema.
A marreta, sozinha, não faz tudo. Enquanto o braço dá a pancada, a mente traça o caminho entre início e fim. Seguimos tentando e errando. Foi assim que cheguei a uma sequência de scripts em Python que, dentro da minha atuação na tutoria da Digital House Brasil, resolveu uma dor operacional conhecida da equipe: dados de alunos espalhados por sistemas que não conversavam entre si tornaram-se um conjunto de arquivos e planilhas preparados para uso compartilhado pela equipe.
A informação existia em sistemas diferentes
O problema não era falta de dados. Era a fragmentação.
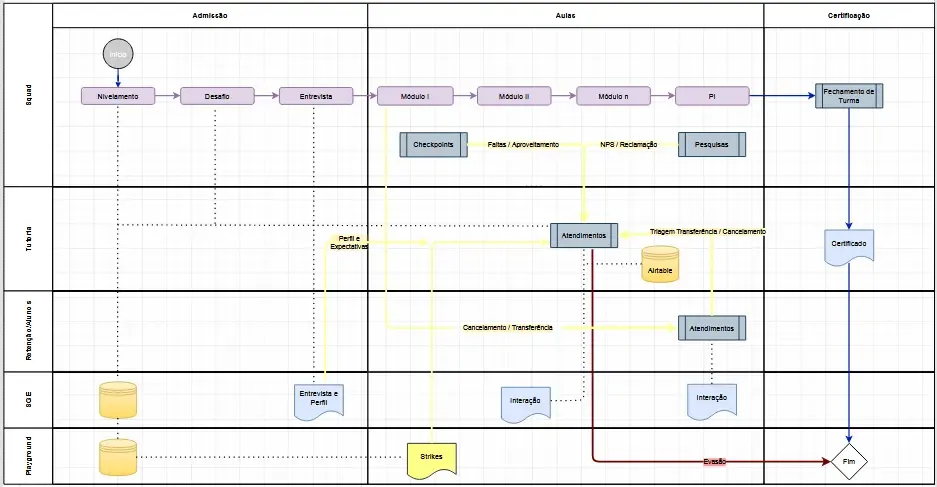
Para acompanhar uma turma inteira, era preciso reunir frequência e atrasos a partir de um sistema, o Sistema de Gestão de Estudantes (SGE), que também concentrava as pesquisas de satisfação; o acesso e consumo de conteúdo de outro, o Playground; e a composição da turma, de uma terceira fonte.
Essas ferramentas eram sistemas fechados entre si, e as integrações disponíveis no dia a dia da equipe não resolviam esse cruzamento. Cada consulta separada custava tempo, e a soma delas dificultava qualquer visão conjunta.
Havia ainda um problema sutil a quem gosta de análise de dados: os sistemas não usavam os mesmos identificadores. O nome de um aluno podia estar registrado de um jeito no SGE e de outro no Playground. Essa diferença bastava para quebrar qualquer fórmula que tentasse cruzar as duas bases automaticamente.
Resolver isso era um problema de integração: decidir o que cada sistema chamava de “mesma coisa” e construir uma ponte confiável entre eles.
Aprender o suficiente para fazer funcionar
A primeira versão dessa ponte era um script rodando no Google Colab, com duas bibliotecas de Python fazendo o trabalho pesado: Selenium, que automatiza a navegação num navegador controlado por código (abre páginas, preenche campos, clica onde for preciso), e BeautifulSoup, que lê o conteúdo de uma página e extrai dali só os pedaços que interessam.
O script entrava no SGE, acessava as páginas de uma turma específica e reunia, num único arquivo, dados como curso, turma, data da pesquisa, média de notas, quantidade de respondentes e porcentagem de resposta. Isso era importado direto numa planilha do Google, por turma, construindo um histórico que antes só existia espalhado pelas telas individuais de cada formulário.
A diferença entre essa consulta e uma simples busca manual é que o script virou um procedimento repetível: bastava trocar o código da turma numa variável, rodar o script e esperar os arquivos saírem prontos, com nomes padronizados, para alimentar a aba correspondente da planilha. Uma consulta isolada resolve uma dúvida pontual; um procedimento reutilizável permite que outra pessoa faça consultas parecidas gastando bem menos tempo de preparação.
O que começou como consulta pontual virou rotina. Um segundo script baixava, direto do SGE, a base de faltas de todos os cursos e separava os registros turma a turma. Os arquivos exportados do Playground, originalmente em Excel, eram convertidos para CSV e renomeados pelo código da turma, para que qualquer pessoa conseguisse localizá-los e integrá-los em suas análises.
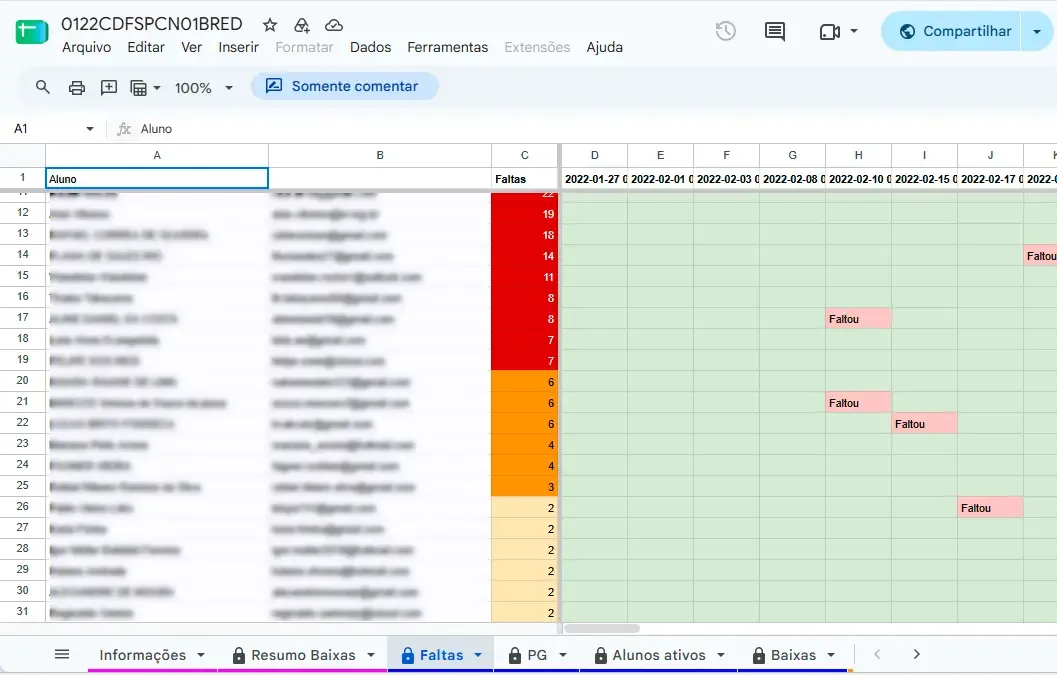
Nem tudo foi automatizado. A lista de alunos que haviam desistido do curso, por exemplo, dependia de uma leitura que nenhum sistema registrava sozinho. O cronograma de aulas e o perfil dos alunos também eram verificados de acordo com as características da turma. Para lidar com a divergência de nomes entre sistemas, criei uma tabela auxiliar — um “de/para” simples — que estabelecia a correspondência entre o nome como aparecia no SGE, no Playground e o nome que a equipe efetivamente usava. Não era uma tarefa acessória de formatação: era a padronização que permitia relacionar os dados com consistência, antes de qualquer automação valer alguma coisa.
Um protótipo que pedia para ser corrigido
Apresentei essa primeira versão da planilha de acompanhamento à equipe. O convite era explícito: aquilo não era uma ferramenta fechada. Tinha inconsistências, e eu preferia expô-las a escondê-las — mostrei números que eu sabia estarem errados e abas que ainda faltava preencher. Pedi sugestões de formatação e de fluxo.
A proposta foi absorvendo ideias que não eram minhas: um colega de tutoria já separava o acompanhamento por grupos de Projeto Integrador, com um olhar qualitativo sobre a percepção de cada professor; outro colega mantinha, à parte, um controle manual de presença para atividades de prática que nenhum sistema cobria.
O que a marreta não resolvia
O resultado técnico é fácil de descrever: dados reunidos, convertidos e disponíveis num lugar só. O resultado que de fato importava dependia de outra coisa — alguém usar esses indicadores para decidir quem precisava de uma conversa, levar um padrão de turma para discutir com os professores, ou entender uma dificuldade antes de encaminhá-la.
Organizar os dados eliminava uma barreira de acesso. Não substituía esse trabalho de interpretação: decidir o que uma informação reunida significava para uma pessoa específica, e o que fazer a partir dali.